
8 月 2 日,欧盟《AI Act》第 50 条正式生效。紧接着 Anthropic 就宣布,要给 Claude 生成的内容加机器可读标记——而且不是只对欧盟用户,是模型层面、全球生效。最让我在意的是文本那块:Anthropic 说,它会把一个”不可感知的水印”直接织进生成的文字里,复制粘贴都去不掉,甚至你改一改,它可能还在。做 SEO/GEO、天天靠 AI 写内容的人,看到这条第一反应大概率是慌:那我用 Claude 写的东西,是不是以后一检测一个准?
先搞清楚:Claude 到底加了什么
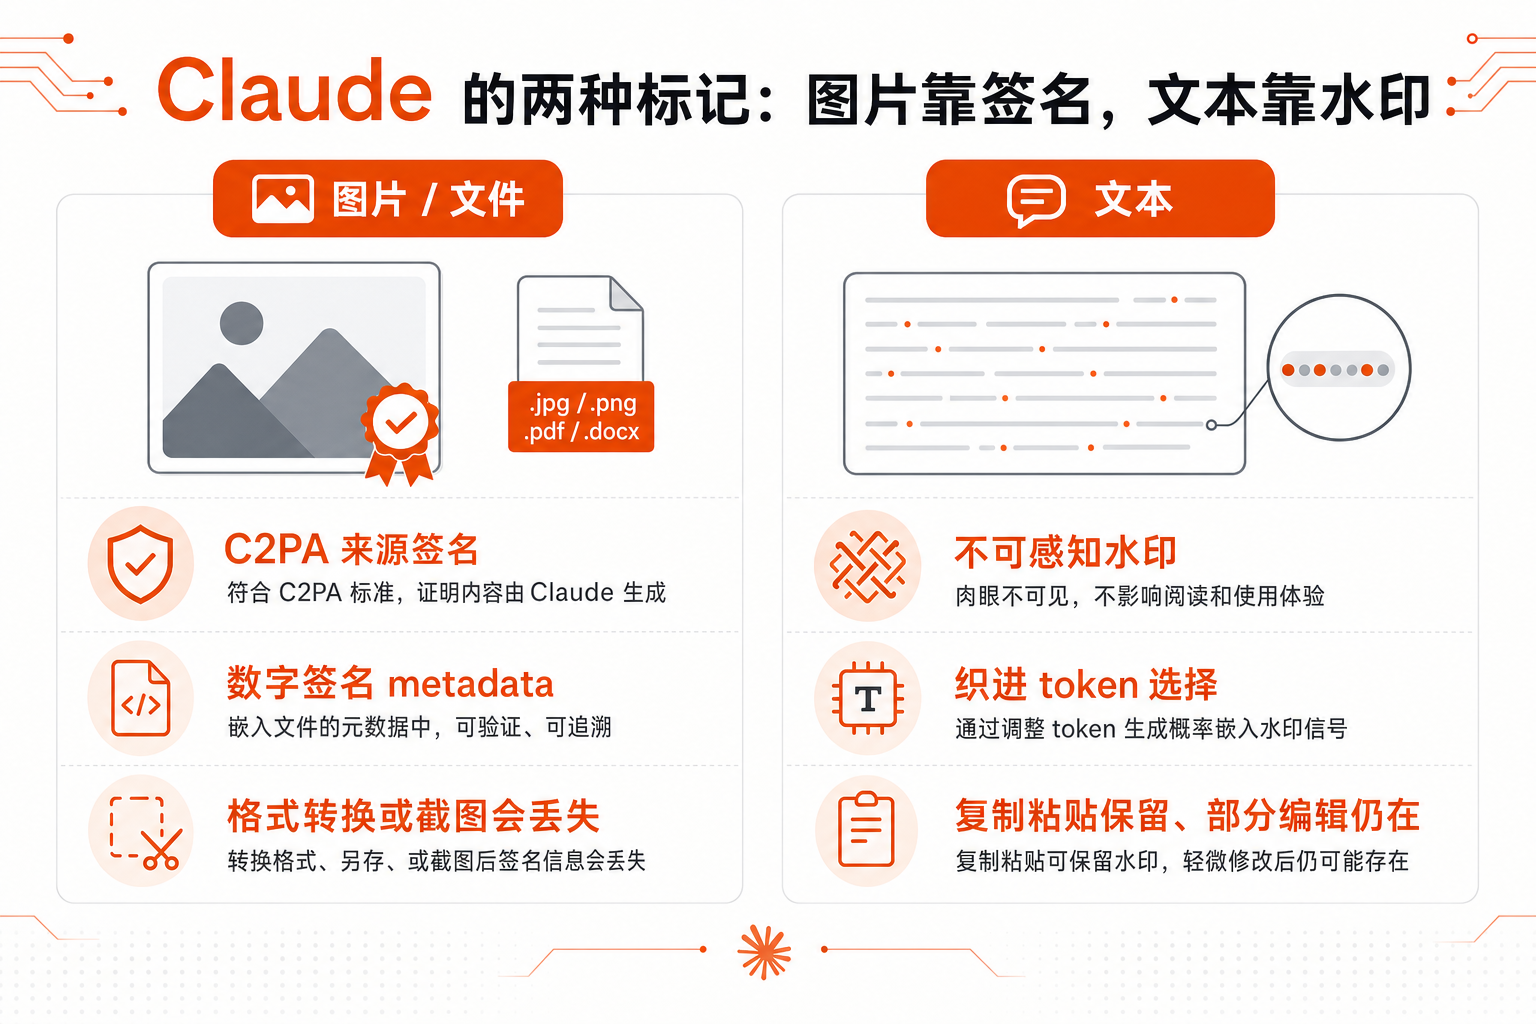
我们先别慌,先把机制拆开。利用 AI的分析,我发现Claude 的标记其实是两套东西。
图片和文件,走的是 C2PA,一种数字签名式的来源证明。它记录”这图是谁生成的”,但本质是 metadata,格式转换、截图、网站重新压缩一下,签名就没了。所以 C2PA 不等于去不掉的水印,它很脆弱。
真正要重视的是文本水印。Anthropic 的表述是”直接编织进文本”,复制粘贴后跟着走,一定程度的编辑之后还可能保留。这说明它大概率不是那种在字里行间塞 Zero-width 空格、隐藏 Unicode 的玄学把戏——那些一 normalize 就没了。它更像是统计型 token 水印,也就是 Google DeepMind 的 SynthID Text 那一路:生成的时候,模型根据一个密钥,轻微抬高某些 token 被选中的概率,长文本里的词分布就会留下一个统计偏差,检测器靠这个偏差打分。关于水印技术,我自己在AI生成文本内容中的水印技术这篇文章中也曾经写过。
还有一个细节值得说:这是模型层的能力,不是按 IP 判定,所以别以为”我不在欧盟、或者我走某个渠道”就能躲开;但旧模型有过渡期,也不是 8 月 2 日一过,所有历史输出就都自动带上了水印。
关键是,Anthropic 现在还没公开完整的算法、检测器、阈值和抗编辑数据。所以网上任何说”我已经摸清了 Claude 水印怎么删”的,都先打个问号。
别急着找”删水印”的工具
这条新闻一出来,我猜一堆人第一反应是去搜”Claude Watermark Remover”。而且我相信已经有文章会告诉大家如何去去除水印了。
不过就像我过去说 AI 检测和拟人化改写对 SEO 是错误方向一样,这个方向大概率是错的。如果水印藏在 token 选择的统计结构里,而不是文件的 metadata,那你做 strip Unicode、normalize whitespace、Markdown 转 HTML、复制粘贴,根本动不了核心的词序列,统计信号该在还在。这就像一碗汤里已经搅匀的盐,你没法一颗颗挑出来,要么重煮一锅,要么就认了。
就算你拿另一个模型把文章 rewrite 一遍,理论上会扰动原来的分布,但 Anthropic 没公开检测阈值,谁也没法保证”改到多少才检测不到”。所以我的判断很简单:与其赌一个”删得干净”的黑科技,不如先承认一个前提——这东西去不掉,至少在官方检测器出来之前,别指望有可靠的办法。
我甚至敢说,接下来市面上会冒出一堆打着”Claude 水印清除”旗号的工具,基本都是收智商税。在官方 detector 出来之前,没人能验证它到底有没有用。
对 SEO/GEO 的真正影响
那做内容的人真正该担心什么?我觉得很多人把重点搞反了。
先说结论:目前没有任何证据表明,Google 会因为检测到 Claude 水印就给你降权。Google 关心的从来不是”是不是 AI 写的”,而是内容质量、有没有用户价值、是不是 scaled content abuse。水印本身不构成惩罚。
所以真正的风险,不是”水印被检测到”,而是”Claude 直出 → 复制粘贴 → 发布”这条流水线本身。过去这条流水线之所以能走,是因为”AI 味”是个软判断,靠人看;现在它背后多了一个硬的、机器可读的信号。就算 Google 今天不拿它排名,未来 CMS、SEO 工具、平台方、甚至甲方,都有可能拿类似的 detector 来筛一遍。
再往我们这行想一层:以后甲方让你出内容,可能会多问一句”这是 AI 直出、还是有人编过的”;你交付一篇 AI 写的文章,客户拿 detector 一测,信号很强,信任当场就崩。对做代运营、做内容交付的人,这比 Google 排名更直接。而且 Google 虽然现在不因水印降权,但它反 scaled content abuse 的态度一直很明确,水印只是让”规模化低质内容”第一次有了可被机器识别的硬证据。
水印本身不可怕;真正被堵上的,是”AI 直出当原创”这条捷径。
正确应对:从”去水印”到”Editorial + Provenance”
所以我的建议是,别再研究怎么删水印了,把力气花在另一件事上——把内容生产链从”生成即发布”,升级成 “生成 + 编辑 + 核查 + 溯源”。
具体就是:生成之后,做事实核查,把品牌自己的知识、一手经验、独有观点补进去,重新组织结构和论证,让这篇文章真的经过了一次”二次创作”,而不只是改了几个词。这跟 Google 要的 E-E-A-T其实是同一件事。
我们可以把把这条链再拆细一点:事实核查、品牌知识注入、独有观点、结构重组,最后是一条清晰的编辑责任链。重点不是”伪装成人工”,而是让最终发布的内容真的经得起查——不管来查的是人,还是机器。说到底,我以前老讲”去AI味”,很多人把它当文风打磨;水印这件事等于给”去AI味”加了一层技术底座——你不是在改语气,你是在改变一个可被检测的生成痕迹。
等哪天 Anthropic 把官方 detector 放出来,这件事还能更进一步:建一个测试矩阵,把 Claude 原文、改 10%、改 30%、人工重写、另一个模型 rewrite 分别送进去测,用数据说清楚”什么样的编辑强度能改变检测信号”。到那时候,”去AI味”就不再是玄学,而是一个可以量化、可以验证的工序。
说到底,Claude 加水印这件事,我不会当成坏消息。它只是把”AI直出当原创”这条捷径,正式堵上了。在当前这个形势下,有价值的信息增益,比去 AI 味儿更重要。
内容这件事,从来没有”复制粘贴”就能做好的捷径。水印只是把这件事,又提醒了所有人一遍。
来源公众号: 老阎杂货铺(ID:gh_59d2a9b32af1)分享一些个人的技术的研究。
本文由 @老阎杂货铺 原创发布于奇赞平台,未经许可,禁止转载、采集。
该文观点仅代表作者本人,奇赞平台仅提供信息存储空间服务。